
- moss-image.com
- MOSS-Image 是什么
MOSS-Image 是什么?
用通俗的语言讲清 OpenMOSS 开源的 5B 文生图模型:它怎么构建、擅长什么、评测成绩如何,以及有哪些不足。
MOSS-Image 是 OpenMOSS 开源的文生图模型系列,于 2026 年 10 月 16 日以 Apache-2.0 协议发布。 它由一个 5B 单流扩散 Transformer、冻结的 Qwen3.5-9B 文本编码器和 FLUX.2 VAE 组成。它的专长是文字与排版:能在图片中渲染长段中英文,支持最长 4,096 tokens 的提示词,还能读取 JSON 布局,为每个物体和每行文字指定边界框。
你可以直接在浏览器里试用、在 ComfyUI 中运行,或调用官方 API。
参数规格一览
| MOSS-Image | |
|---|---|
| 开发方 | OpenMOSS(MOSI.AI) |
| 发布日期 | 2026 年 10 月 16 日 |
| 生成器 | 5B 单流 DiT,42 层,隐藏维度 3072 |
| 文本编码器 | Qwen3.5-9B(冻结) |
| VAE | FLUX.2 VAE(冻结,32 通道潜空间) |
| 提示词长度 | 最长 4,096 tokens |
| 输入格式 | 自然语言、标签序列、JSON 布局,或混合使用 |
| 输出尺寸 | 约 0.25–4 百万像素,任意比例,宽高为 16 的倍数;推荐 1–2 百万像素 |
| 版本 | MOSS-Image-Base、MOSS-Image-SFT |
| 默认采样 | Flow-matching Euler,50 步,CFG 3,shift 5,负向分支跳过第 22 层 |
| 许可证 | Apache-2.0 |
工作原理
生成器是单流 Transformer:Qwen3.5-9B 编码器输出的文本 token 与 FLUX.2 VAE 的图像潜变量拼成一个序列,在 42 层中做联合自注意力。由于文本编码器本身是一个大语言模型,提示词可以很长、很详细——完整的海报需求、标签列表或结构化 JSON 都可以。
根据技术报告,模型是从零预训练的,使用约 30 亿张图片,来自公开数据集(包括 ReLAION、OmniCorpus、DataComp 等)以及富文本和海报数据。除去重和剔除 AI 生成图片外,团队没有做进一步过滤,水印、模糊和压缩痕迹改为写进图片描述。描述被改写为短、中、长三个版本,并配有带边界框的布局 JSON。训练使用 Muon 与 AdamW 混合优化器。
Base 和 SFT 怎么选
两个版本架构和参数完全相同,可以随时切换。
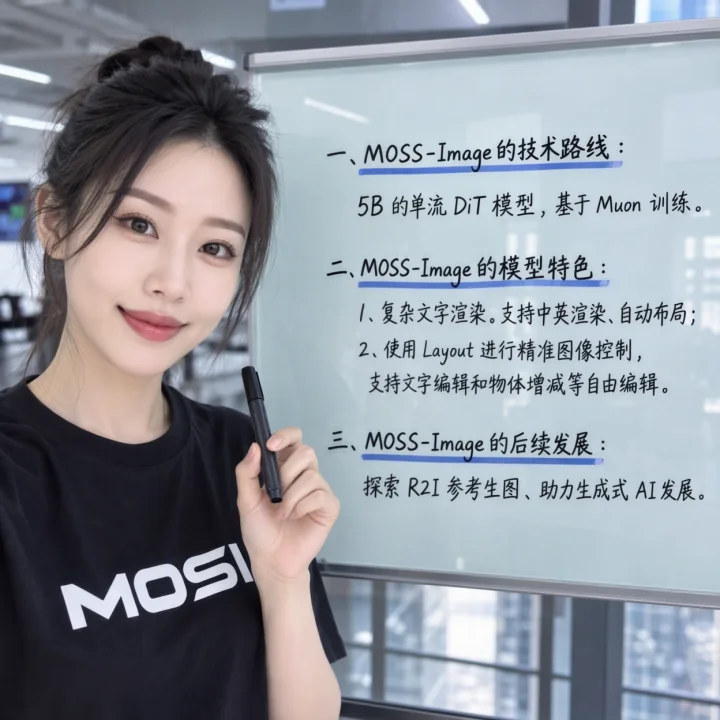
- MOSS-Image-SFT 在精选数据上对 Base 做了微调。在官方白板对比中,它的文字分组更清晰、版面更有条理。日常生成请用 SFT,ComfyUI 的默认模板加载的也是它。
- MOSS-Image-Base 没有做后训练,也没有做 CFG 蒸馏。它的变化更丰富,对 booru 风格的标签式提示词理解更好,是官方推荐的 LoRA 训练起点。在 Base 上使用短提示词时,可以把 CFG 调高(3–6)。
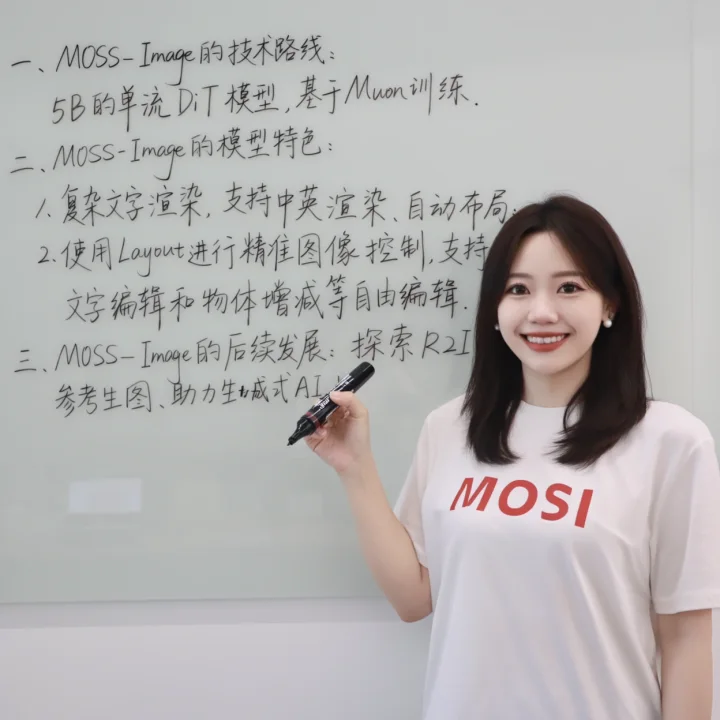
上图为官方对比中的 Base 输出。打开 SFT 版本 对比文字分组效果。
评测数据
以下数据全部来自 OpenMOSS 自己的技术报告,尚未经过独立复现。
长文本渲染 · LongLongTextBench
LLTB 要求模型渲染中英文短、中、长三档文学段落,再测量正确出现的文字比例(六档的 Mean-6 覆盖率)。
| 模型 | Mean-6 文字覆盖率 |
|---|---|
| MOSS-Image | 96.3 |
| Qwen-Image-2512 | 64.9 |
MOSS-Image 在该评测中是开源模型第一,领先 Qwen-Image-2512 31.4 个百分点。
布局精度 · 7Bench
7Bench 衡量生成的物体是否落在指定的框内(224 张图,576 个目标物体)。
| 模型 | mIoU | Layout AUC |
|---|---|---|
| MOSS-Image | 0.679 | 0.703 |
| Ideogram 4.0 | 0.243 | 0.205 |
| Qwen Image 3.0 Pro | 0.169 | 0.176 |
| Seedream 5.0 Pro | 0.167 | 0.179 |
| Nano Banana Pro | 0.149 | 0.163 |
| GPT Image 2 | 0.143 | 0.155 |
所有模型拿到的都是相同的目标框:GPT Image 2、Nano Banana Pro、Seedream 5.0 Pro 和 Qwen Image 3.0 Pro 接收原始 JSON 提示词;Ideogram 4 使用其公开的 FP8 权重,框被转换成它自己的 JSON 格式。mIoU 把漏画的物体记为 0。Ideogram 自己的报告给出的 7Bench mIoU 约为 0.69,OpenMOSS 认为差异来自模型版本、提示词格式和评分实现的不同。
人类偏好 · RealLayoutArena
在针对真实、布局复杂需求的盲测两两投票中,完整的 MOSS-Image 系统获得 1698.70 Elo,仅次于 GPT Image 2,领先 Seedream 5.0 Pro。当所有生成模型都使用相同的增强提示词时,MOSS-Image 主干模型以 1807.34 Elo 在九个模型中排名第一,领先 ERNIE Image(1748.51)。同一研究还发现,在各种提示词策略中,JSON 布局得分最高(1622.87,自然语言为 1506.20)。
擅长什么
- 图中文字: 海报、菜单、招牌、标签、白板和信息图,中文、英文或中英混排皆可。
- 长而详细的提示词: 最长 4,096 tokens,足以写下完整的设计需求。
- 精确摆放: 用 JSON 布局为每个元素指定边界框。我们的布局编辑器可以帮你自动生成。
- 不只是文字: OpenMOSS 重点展示了二次元和写实风格,可在首页查看官方的雨夜街景和插画示例。
- 高效、易微调: 5B 生成器配合量化权重可在消费级显卡运行,Base 专为 LoRA 训练设计。
已知局限
- 官方模型只支持文生图。 没有图片输入;目前编辑图片需要在 ComfyUI 开发分支上使用社区 LoRA。
- 布局控制仍属实验性。 框是强引导,不是硬性边界;我们的测试中文字有时会高出框。参见真实示例。
- 长文本仍需校对。 96% 的覆盖率意味着部分段落仍会出错,生僻字和很小的文字最难。
- 英文提示词最稳。 技术报告指出训练描述“以英文为主,没有专门的中文描述标注”。中文提示词可用,中文文字也能渲染得很好,但结果波动可能更大。
- SFT 在部分图片上会出现竖向色带。 社区的 DeBand LoRA 可以缓解。
- 默认需要 50 步。 因此比蒸馏模型慢;社区的 8 步 DMD LoRA 以少量画质换取速度。
使用方式
| 途径 | 适合 | 成本 |
|---|---|---|
| 在线生成器 | 立即试用,任意比例,最高 200 万像素 | 送 3 张,之后用积分 |
| Hugging Face Space | 用自己的 HF 额度免费生成 | 免费,受每日 ZeroGPU 时长限制 |
| ComfyUI | 本地工作流、布局、LoRA | 自己的显卡,免费 |
| Diffusers / Python | 脚本与自定义管线 | 自己的显卡,免费 |
| 官方 MOSI API | 应用集成与自动化 | Beta 期间限时免费,需 API Key |
时间线
- 2026 年 10 月 16 日 — 发布 MOSS-Image-Base 与 MOSS-Image-SFT 代码和权重;ComfyUI、SGLang、vLLM-Omni 首日支持。
- 2026 年 10 月 18 日 — KohakuMossTrainer 发布,支持 LoRA 与全量微调。
- 2026 年 10 月 19 日 — 技术报告发布于 arXiv(2610.23374)。
- 2026 年 10 月 20 日 — MOSS-Image 上线官方 MOSI API 平台;ComfyUI 加入社区颜色与深度控制适配器。
- 2026 年 10 月 22–23 日 — ComfyUI 开发分支支持 MOSS-Image 编辑 LoRA(尚未进入稳定版)。
常见问题
MOSS-Image 是谁开发的?
MOSS-Image 由 OpenMOSS 团队(MOSI.AI)开发,也就是 MOSS 语言与语音模型背后的团队。代码和权重发布在 GitHub、Hugging Face 和魔搭社区(ModelScope)。
MOSS-Image 什么时候发布的?
Base 与 SFT 权重于 2026 年 10 月 16 日发布;技术报告于 10 月 19 日上线 arXiv(arXiv:2610.23374);官方 MOSI API 于 10 月 20 日上线 MOSS-Image。
MOSS-Image 是开源的吗?
权重和独立的推理管线代码采用 Apache-2.0 协议发布,允许商用。第三方组件沿用各自的许可证。
MOSS-Image 有多少参数?
图像生成器是一个 5B 参数的单流扩散 Transformer,另外使用冻结的 Qwen3.5-9B 文本编码器和 FLUX.2 VAE,因此完整管线大于 5B。
MOSS-Image 能编辑图片吗?
模型本身不能:官方 Base 和 SFT 只支持文生图。自 2026 年 10 月 22–23 日起,ComfyUI 开发分支可以加载社区编辑 LoRA(MOSS Image Edit),按文字指令修改颜色、服装、光线或风格。它尚未进入 ComfyUI 稳定版,本站在线生成器也暂不提供。